
- gf24240 的博客
《梦溪笔谈·笔记》CSP 复习:字符串之字符串哈希
-
 gf24240
LV 9
@
2026-9-26 19:35:34
前言
字符串哈希,就是将字符串映射到范围较小的数字,以方便计算。
哈希表与字符串哈希
这两个东西的名字里都有哈希,但其实是非常不同的东西。
哈希表
哈希表是一种表示键值对关系的数据结构。

键(key)可以是数字、浮点数、字符串甚至是结构体。
而字符串哈希是将字符串映射到数字。
字符串哈希方法
可以利用一种类似进制转化的方法。把字符串看作是一个 进制的数,每个字符对应一个数字。例如定义 ,且 。那么 就可以表示为 。
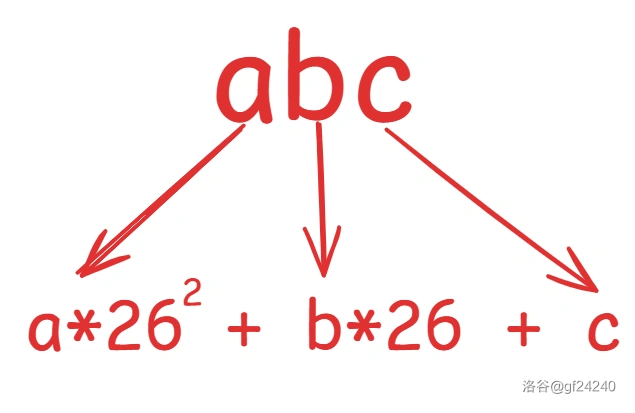
当然,这个 可以是别的数。不过最好是质数并且一定要大于字符集大小。
另一种方法
上面的公式:, 的指数依次是 。从高往低,和标准的进制一样。
也有另一种:。 的指数依次是 ,从低往高。这样会没那么方便提取子串,所以通常用的都是从高往低。
取模
同时需要注意取模。如果字符串很长。有 。也就是说,在不取模的情况下,最大的权值需要 那么多。显然是不能接受的。所以需要取模。模数好选,随便选个大一点的质数。质数能让哈希分布均匀,减少「冲突」。
可以将模数 定义为 、 之类的。
冲突
例如字符串 在 时的哈希值就是 。同时, 的哈希值也是 (不信你就试一下)
解决冲突
首先, 越大越好。因为值域更大。
还可以直接使用 ,即使用 unsigned long long 自然溢出。大概时间也会快一些?
或者可以使用双哈希。定义两个 分别计算。只有两个 的情况下哈希值都相同时,两个字符串才算是相同。
也可以用随机 。随机构造 ,这样出题人就不能特意卡了。
子串比较
如果有很多字符串进行操作,且不需要频繁提取子串。这个时候直接写一段哈希函数进行操作就行了。例如:P2786、P2580 之类的。例如:
const int Base = 131, Mod = 998244353;

int hs(string str)
{
	int ret = 0;
	for (int i = 0; i < str.size(); ++i)
		ret = (ret * Base % Mod + str[i]) % Mod;
	return ret;
}
不过有些题目,只有少数字符串且需要频繁地进行子串比较。此时就可以一个数组存储子串的信息。例如:P10468。定义 表示前 个字符的哈希值, 表示 。如果要提取字符串 中 这一段,则可以直接:。即公式:。
通过定义,可以知道:,。代入上面的公式可以证明:
$$\begin{aligned} &h_j-h_i\times p_{j-i+1} \\ =&(\sum^{j}_{k=1}d_k\times Base^{j-k}) - (\sum^{i-1}_{k=1}d_k\times Base^{i-1-k}) \times Base^{j-i+1} \\ =&(\sum^{j}_{k=1}d_k\times Base^{j-k}) - (\sum^{i-1}_{k=1}d_k\times Base^{i-k-1+j-i+1}) \\ =&(\sum^{j}_{k=1}d_k\times Base^{j-k}) - (\sum^{i-1}_{k=1}d_k\times Base^{j-k}) \\ =&\sum^{j}_{k=i}d_k\times Base^{j-k} \end{aligned}$$正好就是 的哈希值。
上面那一大坨是水的,本人一点数学都不会。下面是我的理解方法:
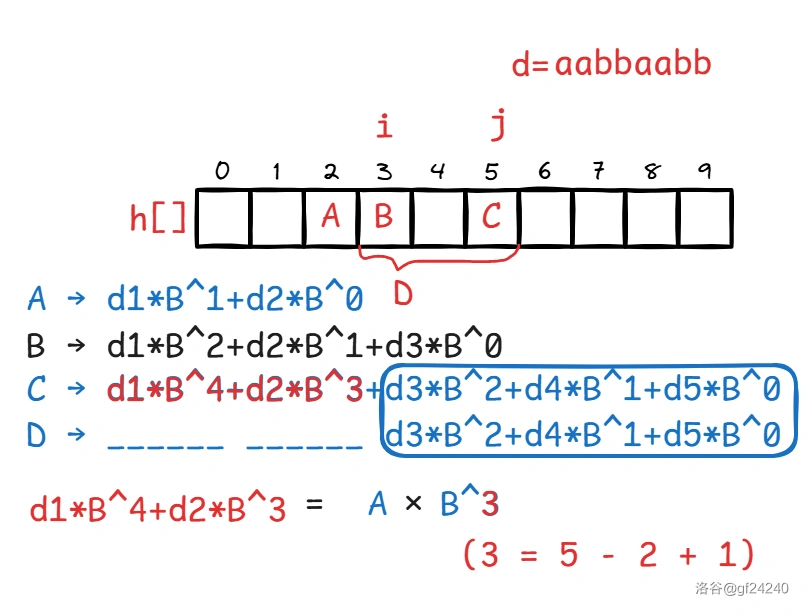
(注:使用 代替 ,不然太长了)
参考代码(使用 unsiged long long 自然溢出):
#define ull unsigned long long
using namespace std;

const int N = 1e6 + 6, Base = 211;
ull h[N], p[N];
string str;

void init()
{
	p[0] = 1;
	for (int i = 1; i <= n; ++i)
	{
		h[i] = h[i - 1] * Base + str[i];
		p[i] = p[i - 1] * Base;
	}
}

ull get(int l, int r)
{
	return h[r] - h[l - 1] * p[r - l + 1];
}