
- gf24240 的博客
《梦溪笔谈·笔记》2026/10/9:论并查集与西欧封君封臣制底层逻辑区别
-
 gf24240
LV 9
@
2026-10-10 23:13:31
前言
月考前那节课没有去,在这里对 dxd 表示歉意。
先复习一些历史知识。这对深入理解并查集优化有关键作用。
西欧封君封臣制与西周分封制异同点
如下示意图:
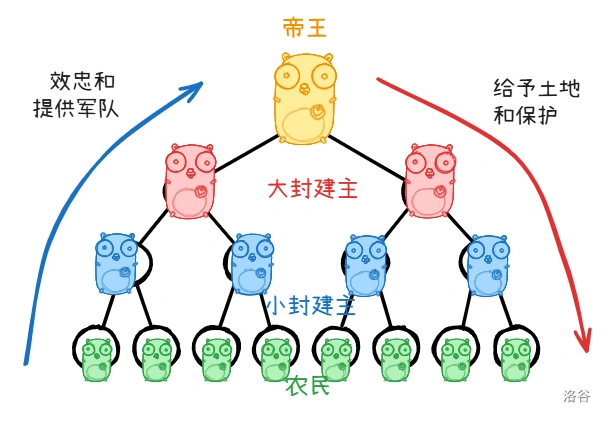
西欧封君封臣制示意图
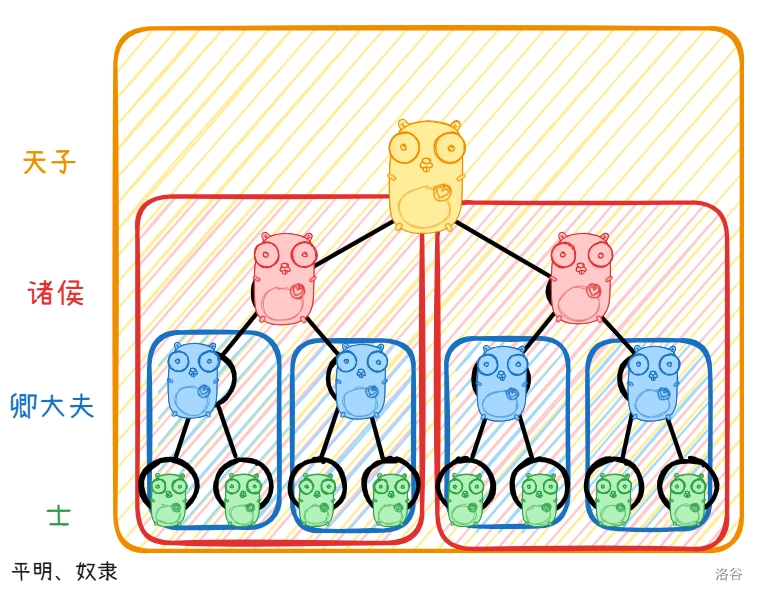
西周分封制示意图
| 点 | 具体 | 西欧封君封臣制 | 西周分封制 |
|---|---|---|---|
| 相同点 | 层层分封,等级森严 | ||
| 以土地为纽带 | |||
| 不同点 | 关系 | 契约关系 | 血缘关系 |
| 领导 | 只能领导直属下级;只受直属上级领导。 | 周天子是天下共主 | |
内容很多,但这篇 blog 只关注这一个不同点:周天子是天下共主。
在西欧封君封臣制中,封君只能指挥直属下级。这就导致,在打仗时:
- 国王需要向大封建主征兵;
- 大封建主需要向小封建主征兵;
- 小封建主需要向农民征兵;
- ……
效率非常低。而在“溥天之下,莫非王土;率土之滨,莫非王臣。”的西周,效率就能大大提升。
并查集
就比如说这个图:
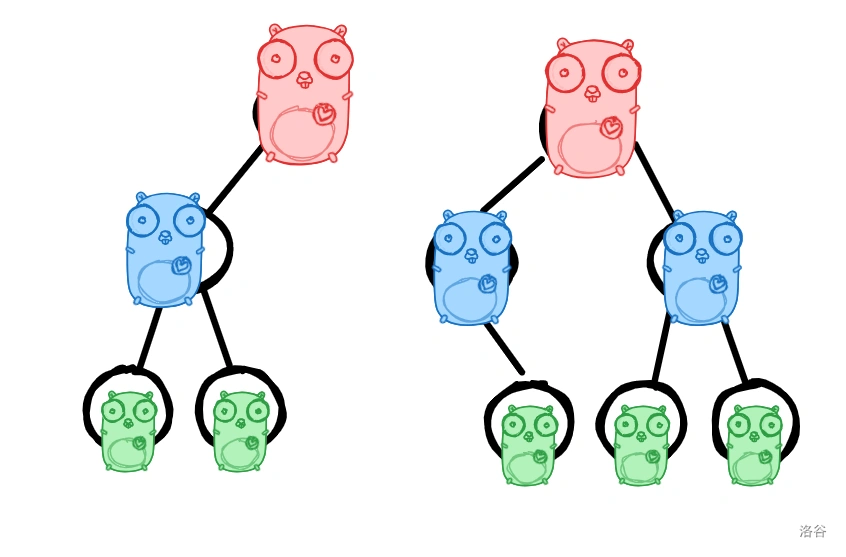
如何判断两只小拨鼠是否在同一棵树(同一个家族)里?
- 类似西欧封君封臣制,可以一直向上寻找直到根。时间复杂度是 的。
- 按照西周分封制,可以直接记录每个节点最上层的根。这样就能很快判断。具体的,时间是 ,约等于 。
并查集还支持合并操作。具体是直接把一棵树挂到另一棵树脚下。
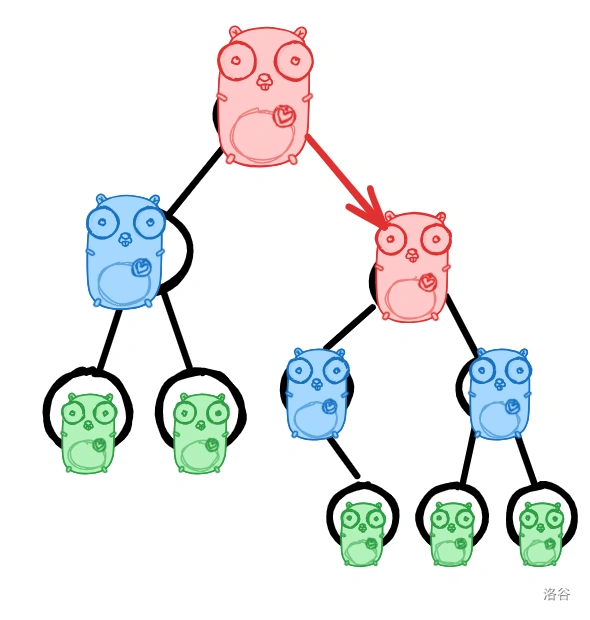
朴素查找
定义 表示 节点的家族的根。初始化时,每个节点都各自是个家族,根是自己。即 。
查找时,递归往上找直到 。
void init()
{
	for (int i = 1; i <= n; ++i)
		f[i] = i;
}

int find(int u)
{
	if (f[u] == u) return u;
	return find(f[u]);
}
查找优化
思路就是“溥天之下,莫非王土;率土之滨,莫非王臣。”。查找时把路径上所有的点都直接挂在根的脚下。如图,查找图示箭头指向的节点的根。
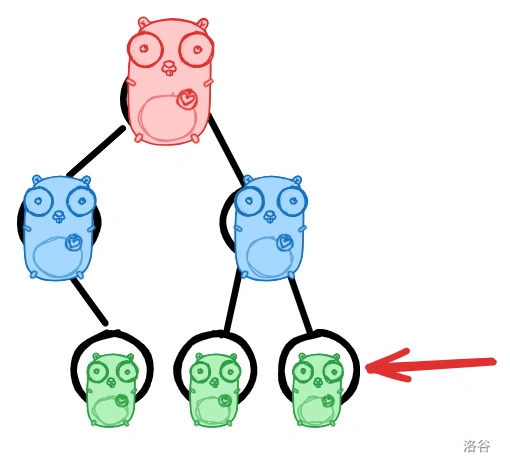
一直往上查找直到 。
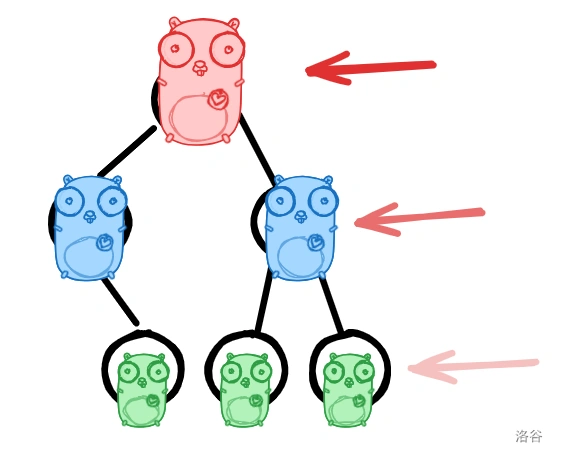
递归回来的时候,把路径上所有的点都挂到根下面。
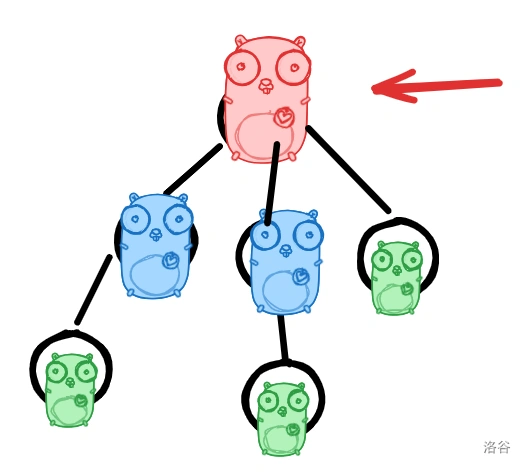
void init() // 不变

int find(int u)
{
	if (f[u] == u) return u;
	return f[u] = find(f[u]);
}
随机乱合并
只需要找到两点的根,合并起来。
下面有更好的“按秩合并”。不过如果数据随机,直接把一个挂到另一个上就行了。时间复杂度均摊 。通常够用。
void uni(int u, int v)
{
	u = find(u); v = find(v);
	f[v] = u;
}
按秩合并
思路就是把矮树挂到高树下。
定义 表示以 为根的子树的高度上界。合并 和 时,首先找到根。
分类讨论:
- :直接把 挂到 下并不需要修改。
- :
swap一下 和 ,化为情况 。 - :把 挂到 下,并把 增加 (因为把 这么多点挂到 下了)。
注意如果按秩合并,需要初始化 。
void uni(int u, int v)
{
	u = find(u); v = find(v);
	if (rk[u] < rk[v]) swap(u, v);
	f[v] = u;
	if (rk[u] == rk[v]) ++rk[u];
}
后记
西欧封建主绝对不会喜欢并查集这个东西,因为“我的附庸的附庸不是我的附庸”。