
- gf24240 的博客
关于搜索算法2 & 递推实现递归
-
 gf24240
LV 7
@
2026-8-29 20:47:21
前言
暑假要结束的时候想出来的。真的不是因为无聊。
根据标题的顺序,先说 DBS 再说栈模拟递归。
DFS (大鼻屎) 简介
DBS,是融合了 DFS 和 BFS 各自的缺点的算法。可以看:关于搜索算法 1。大概就是把 BFS 的队列改成栈,拥有 DFS 的深度优先顺序,和 BFS 占用空间大的缺点。
代码可以参考:
void dbs()
{
	stack <stu> q;
	q.push(stu{1, 1, num});
	while (q.size() != 0)
	{
		stu f = q.top();
		q.pop();
		if (num - 1 == n * m)
		{
			return;
		}
		for (int i = 1; i <= 4; i++)
		{
			int nx = f.x + dx[i];
			int ny = f.y + dy[i];
			if (check(nx, ny))
			{
				a[nx][ny] = num++;
				q.push(stu{nx, ny, num});
			}
		}
	}
}
可能用遍历树的代码会直观一点:
void dbs(int u)
{
	struct fu { int u, fa; };
	stack <fu> sk;
	sk.push({1, 0});
	while (sk.size())
	{
		fu f = sk.top();
		sk.pop();

		cout << f.u << ' ';
		for (int v : g[f.u])
		{
			if (v == f.fa) continue;
			sk.push({v, f.u});
		}
	}
}
遍历顺序探究
就以这个图为例:
7
1 2
1 3
1 4
2 5
2 6
3 7
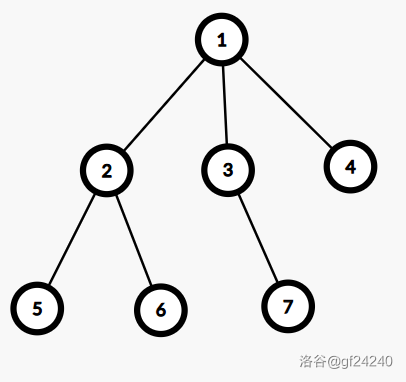
- 首先将 入栈。
- 取出栈顶 ,顺序将与其相连的 入栈。此时栈:。
- 取出栈顶 ,没有节点与其相连。此时栈:。
- 取出栈顶 ,将 入栈。此时栈:。
- 取出栈顶 ,没有点与 相连。此时栈:。
- 取出栈顶 ,将 入栈。此时栈:。
- 取出栈顶 ,没有节点与 相连。
- 取出栈顶 ,没有节点与 相连。
遍历顺序:。图示:
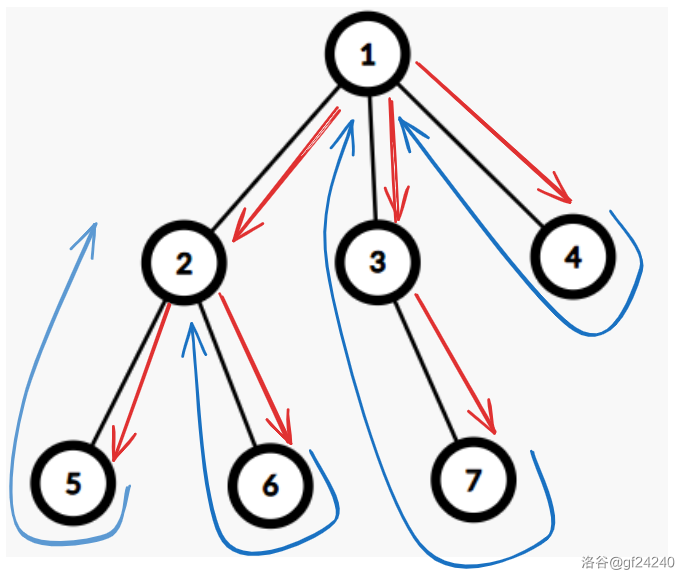
此时就会发现:这不就是镜像的 DFS 遍历顺序吗?
那如果将遍历顺序镜像(倒序),那是不是就能得到真正的 DFS 序了!
先看看正常的 DFS 序
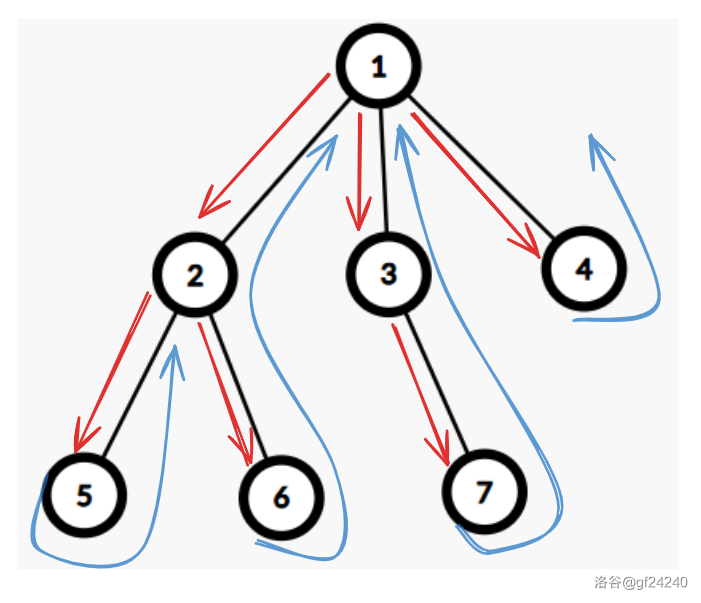
DFS 访问顺序:
- 调用 ,遍历与 相连的节点:
- 调用 ,遍历与 相连的节点:
- 调用 ,没有相连的节点。回溯。
- 调用 ,没有相连的节点。回溯。
- 调用 ,遍历与 相连的节点:
- 调用 ,没有相连的节点。回溯。
- 调用 ,没有相连的节点。回溯。
- 调用 ,遍历与 相连的节点:
DFS 序:。
将 DBS 倒序
- 首先将 入栈。
- 取出栈顶 ,顺序将与其相连的 入栈。此时栈:。
- 取出栈顶 ,将 入栈。此时栈:。
- 取出栈顶 ,没有节点与 相连。此时栈:。
- 取出栈顶 ,没有节点与 相连。此时栈:。
- 取出栈顶 ,将 入栈。此时栈:。
- 取出栈顶 ,没有点与 相连。此时栈:。
- 取出栈顶 ,没有节点与其相连。
遍历顺序:。正好就是正常 DFS 的顺序。
问题
但是 DBS 还是有一个问题:无法回溯。因为是从 BFS 改的,而且 BFS 根本就不回溯。这样问题就很严重了,不能回溯,就不能求出其他路,甚至会无法求出最短路。
所以在“栈模拟递归”里,引入了一个“值帧”的概念,只有值帧达到最大才会触发 pop。否则会搜索下一个状态。
总结
现在 DBS 可以翻身了(如果它的遍历顺序能先翻身)。它不再是结合了两者的缺点,而是递推版的 DFS,是对 DFS 的优化。
使用栈实现递归
(个人观点,仅供参考。而且我还不会带返回值的递归)
看这一段访问顺序:
- 调用 ,遍历与 相连的节点:
- 调用 ,遍历与 相连的节点:
- 调用 ,没有相连的节点。回溯。
- 调用 ,没有相连的节点。回溯。
- 调用 ,遍历与 相连的节点:
- 调用 ,没有相连的节点。回溯。
- 调用 ,没有相连的节点。回溯。
- 调用 ,遍历与 相连的节点:
可以发现:递归的调用呈现一种树形结构,而且先调用的后才结束,是先入后出 LIFO 的顺序。如果能将并列的状态全都放进去,那就可以递推地完成递归。
这样就可以使用一个栈,里面用结构体存参数列表,还有一个调用次数。
计算阶乘
(因为我不会带返回值的递推,所以递归也只好不用返回值了)
int f[2026]; // 答案

void jc(int x) // 当前参数
{
	if (x <= 1) // 边界值
	{
		f[x] = 1;
		return;
	}
	jc(x - 1); // 第一次递归调用
  // 第一次调用完
	f[x] = f[x - 1] * x;
}

jc(x); // 外界初始调用
按照上面 ↑ 的内容,这就相当于是 DFS。下面 ↓ 是用栈模拟递归的求阶乘:
void jc2(int x)
{
	struct fu { int x, t; };
  // x 表示数字,是参数列表
  // t 是调用次数,或者值帧。不同次数下会有不同的操作
	stack <fu> sk;
	sk.push({x, 0}); // 初始调用

	while (sk.size())
	{
		fu ff = sk.top();
		sk.pop();

		int x = ff.x; // 当前参数
		if (x <= 1) // 边界值
		{
			f[x] = 1;
			continue; // return
		}
		if (ff.t == 0) // 第一次调用
		{
			sk.push({x, 1}); // 先把自己的下一次调用放进来
			sk.push({x - 1, 0}); // 递归调用
		}
		else // f.t == 1
		{ // 第一次调用完
			f[x] = f[x - 1] * x;
		}
	}
}
内容是一一对应的。这样就可以提取递推版递归的模板了:
void 函数()
{
	struct 结构体
	{
		参数列表
		int t; // 调用次数
	};
	stack <结构体> 栈;
	栈.push(初始状态); // 有多个的话:
	// 1. 建立虚拟根节点
	// 2. 倒序放将来
	while (栈非空)
	{
		提取当前状态 = 栈.顶;
		当前状态出栈;

		if (符合边界条件)
		{
			边界处理;
			continue; // 跳过
		}
		if (状态.t == 0) // 第一次调用
		else if (t == 1) ...
		...
	}
	结束
}
其实发现结构很像 BFS。这也是 DBS 的由来。
调用次数的含义
是这样的,如果有一个递归函数:
void f(int x)
{
	if (x <= 1) return ;

	x -= 10;
	f(x * 2);

	f[x] += 10;
	f(x - 1);

	cout << x << ' ';
	f(x - 2);

    b.push_back(x);
}
那么,按照下面的注释:
void f(int x)
{
	if (x <= 1) return ; // 边界值

	x -= 10;
	f(x * 2); // 这就是第一次调用

	f[x] += 10;
	f(x - 1); // 这是第二次调用

	cout << x << ' ';
	f(x - 2); // 这是第三次调用

	b.push_back(x);
}
开始时,将 入栈。
x -= 10 这一句,就是 时应该执行的。f(x * 2) 后将 和 入栈。本来递归调用顺序是先 再 的,但这是递推版,所以倒序。后面同理。这就是调用次数的意义。
记忆化
如果定义了记忆化数组,那也可以和递归一样做记忆化了。只需要在边界值的后面、执行的前面,加上“如果访问过就跳过”的代码即可。